Microsoft vs Facebook leállás
Mindig az a csúnya BGP. Úgy tűnik, időnként a világ legnagyobb informatikai vállalatait is képes térdre kényszeríteni néhány rosszul sikerült hálózati konfiguráció.
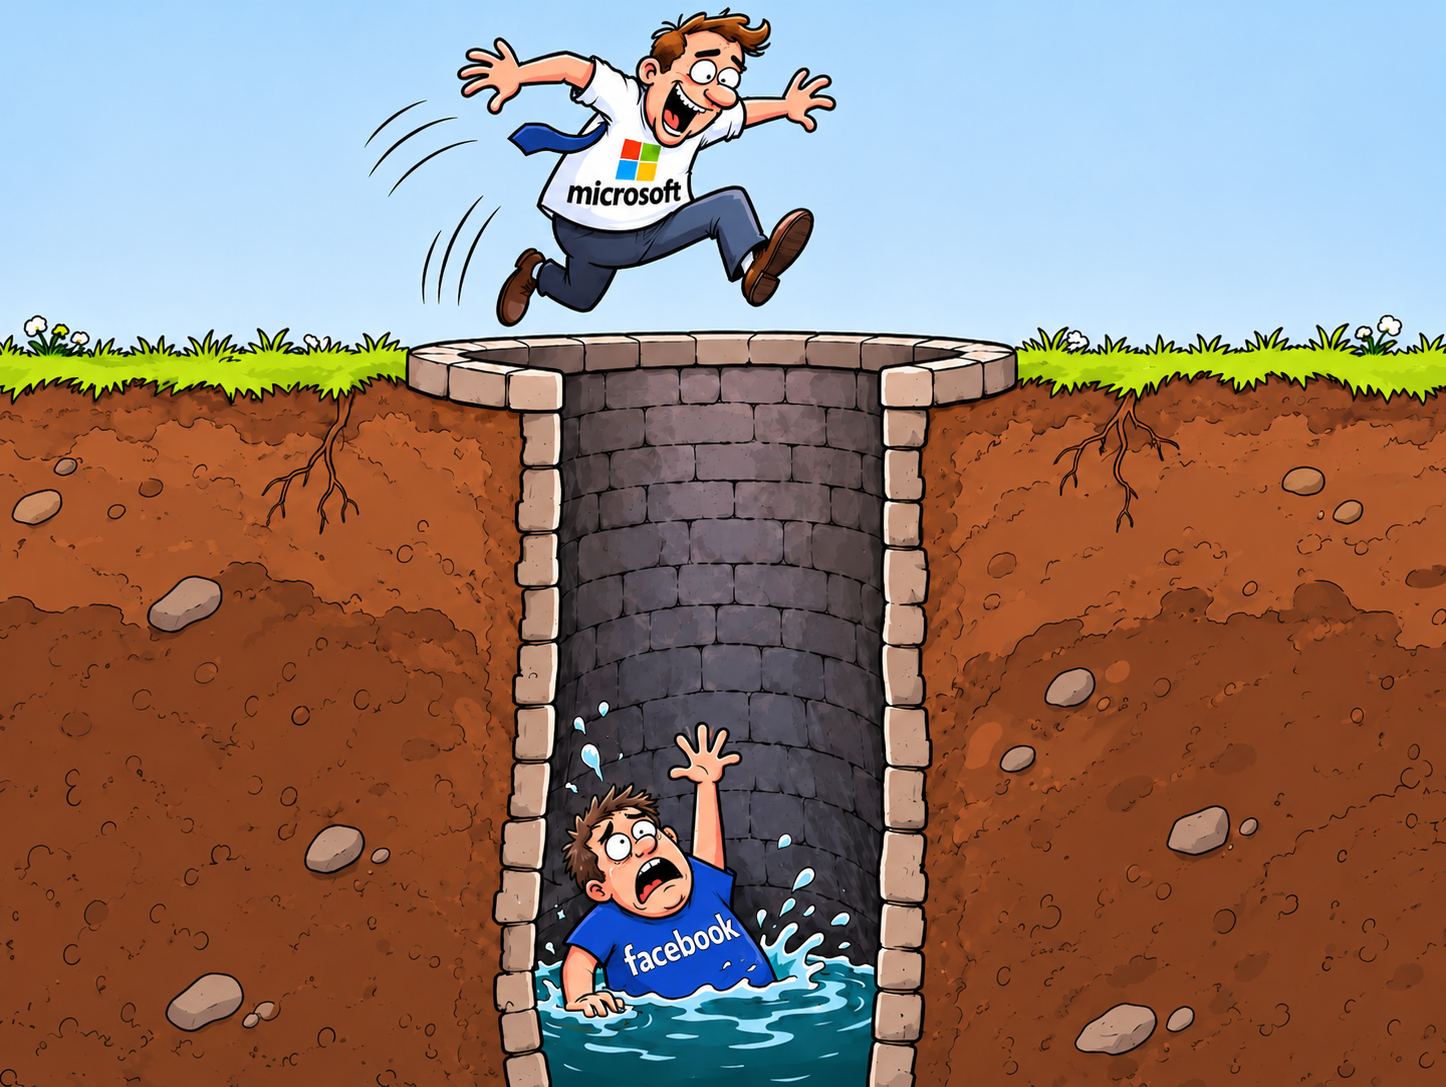
Mindig az a csúnya BGP. Úgy tűnik, időnként a világ legnagyobb informatikai vállalatait is képes térdre kényszeríteni néhány rosszul sikerült hálózati konfiguráció.
A Microsoft pénteki leállása
2026. november 13-án a Microsoft szolgáltatásainak jelentős része vált elérhetetlenné. Outlook, Teams, Exchange Online és számos más Microsoft 365 szolgáltatás működésében jelentkeztek problémák. A Microsoft tájékoztatása szerint egy korábbi hálózati kapacitásbővítés során keletkezett hibát egy későbbi konfigurációváltozás hozott felszínre. Ennek következtében kiszolgálókapacitás esett ki, a megmaradt infrastruktúra pedig túlterhelődött.
Hogy pontosan milyen hálózati konfiguráció okozta a problémát, azt egyelőre nem tudjuk. Én mindenesetre a BGP-re gyanakszom.
A BGP, vagyis a Border Gateway Protocol az internet egyik alapvető építőköve. Ez gondoskodik arról, hogy a különböző szolgáltatók és autonóm rendszerek hálózatai tudják, merre találják egymást. Ha egy vállalat hibásan módosítja a BGP-konfigurációját, akár teljes hálózatokat is eltüntethet az internetről. A szerverek működnek, az alkalmazások futnak, csak éppen senki nem talál oda hozzájuk.
Ismerős történet?
Amikor a Facebook eltűnt az internetről
2021. október 4-én a Facebooknak sikerült valami nagyon hasonlót produkálnia. Egy hibás hálózati karbantartási művelet következtében megszakadt a saját adatközpontjai közötti kapcsolat. A DNS-szervereik ezt hibának érzékelték, és automatikusan visszavonták a hozzájuk vezető BGP-útvonalakat.
A Facebook, az Instagram és a WhatsApp gyakorlatilag eltűnt az internetről.
De szerintem nem is ez volt a történet legérdekesebb része.
A DNS is közös hibapont lehet
A Facebook ugyanis a saját domainjeinek DNS-kiszolgálását is a saját infrastruktúráján üzemeltette. Amikor a BGP-útvonalak eltűntek, a világ DNS-szerverei többé nem tudták feloldani a Facebook domainjeit.
Ez pedig nemcsak a Facebook felhasználóinak okozott problémát.
Rengeteg más weboldal hivatkozott Facebookhoz tartozó domainekre. Beágyazott tartalmak, JavaScript-könyvtárak, követőkódok, autentikációs szolgáltatások és mindenféle külső erőforrások függtek tőlük. Egyes weboldalak hibásan vagy lassan töltődtek be, másokon a Facebook-alapú bejelentkezés vált használhatatlanná. A sikertelen DNS-lekérdezések ráadásul jelentős többletterhelést okoztak az internet DNS-infrastruktúrájában.
Vagyis egyetlen cég hálózati hibája az internet számos más szolgáltatását is érintette.
Pedig az egész DNS-oldali problémának lett volna egy meglehetősen egyszerű architekturális ellenszere.
A Facebook domainjeit kiszolgáló autoritatív DNS-szervereket legalább részben független szolgáltatóknál kellett volna elhelyezni. Például az egyik névszervert a saját hálózatukban, egy másikat pedig egy teljesen független autonóm rendszerben. Így ha a Facebook teljes hálózata eltűnik az internetről, a DNS-feloldás akkor is működőképes maradhatott volna.
Természetesen ettől maga a Facebook még nem működött volna. De legalább a névfeloldás nem omlott volna össze vele együtt.
A történet másik abszurditása az volt, hogy a Facebook saját helyreállítási eszközeinek egy része is elérhetetlenné vált. A mérnököknek végül fizikailag kellett bejutniuk az adatközpontokba, hogy helyreállítsák a hálózatot.
Magyarán sikerült olyan rendszert építeniük, amelynek a megjavításához szükséges infrastruktúra részben attól a rendszertől függött, amelyik éppen elromlott.
Mi változott öt év alatt?
És most jön az igazán érdekes rész.
Kíváncsiságból megnéztem, mi változott azóta, hiszen több mint öt év telt el a történtek óta.
A facebook.com domain továbbra is négy autoritatív DNS-szervert használ: a.ns.facebook.com, b.ns.facebook.com, c.ns.facebook.com és d.ns.facebook.com.
Ezek mindegyike a Meta saját AS32934 autonóm rendszeréhez tartozik.
Vagyis a nyilvánosan látható DNS-architektúra alapján továbbra sincs olyan független, másik autonóm rendszerben működő névszerver, amely a Meta saját hálózatának teljes routingkiesése esetén is biztosítaná a facebook.com névfeloldását.
Ez persze nem bizonyítja, hogy a 2021-es hiba ma is ugyanúgy előidézhető. A Meta azóta számos belső védelmet építhetett ki, amelyek kívülről nem láthatók.
A közös hálózati függőség viszont továbbra is létezik.
A helyreállítás ördögi köre
És van itt még egy érdekes kérdés.
Tegyük fel, hogy valamilyen konfigurációs hiba következtében a Meta teljes AS32934 autonóm rendszere eltűnik az internet routing tábláiból.
A DNS-szerverek elérhetetlenné válnak. Ha pedig a helyreállításhoz szükséges valamelyik menedzsmentrendszer, autentikációs szolgáltatás vagy konfigurációs eszköz szintén ezektől a DNS-szerverektől függ, akkor könnyen kialakulhat egy ördögi kör.
Nem lehet helyreállítani a hálózatot, mert nem érhető el a helyreállításhoz szükséges infrastruktúra. Az infrastruktúra pedig azért nem érhető el, mert a hálózat nem működik.
Természetesen egy megfelelően kialakított, független menedzsmenthálózattal és DNS-től független vészhelyzeti hozzáféréssel ez elkerülhető. A kérdés csak az, hogy ezek valóban függetlenek-e.
Vissza a Microsofthoz: mire elég az anycast?
És itt kanyarodnék vissza a Microsofthoz.
A microsoft.com domain DNS-kiszolgálását szintén a vállalat saját Azure DNS infrastruktúrája biztosítja. A Microsoft globálisan elosztott, anycast alapú rendszert használ, amely számos helyi meghibásodás ellen védelmet nyújt.
De vajon mi történne, ha egy hibás központi hálózati konfiguráció egyszerre érintené a DNS-kiszolgáláshoz szükséges BGP-útvonalakat?
Az anycast ugyanis nem csodaszer. Ha minden kiszolgálópont ugyanannak a hibás routingvezérlésnek van alárendelve, akkor a földrajzi redundancia önmagában nem sokat ér.
Nem állítom, hogy a pénteki Microsoft-leállást BGP-hiba okozta. A jelenleg rendelkezésre álló információk ezt nem bizonyítják. Azt viszont igen, hogy egy hálózati konfigurációs probléma képes volt egyszerre több kritikus felhőszolgáltatás működését megzavarni.
Redundancia vagy valódi függetlenség?
A Facebook és a Microsoft példája szerintem ugyanarra az alapvető architekturális kérdésre világít rá.
Mit ér a redundancia, ha a redundáns rendszerek ugyanattól a közös infrastruktúrától függenek?
Lehet száz adatközpontunk, több ezer szerverünk, földrajzilag elosztott szolgáltatásunk és automatikus failover mechanizmusunk. Ha azonban mindegyik működése ugyanazon a kritikus vezérlési ponton múlik, akkor valójában továbbra is van egyetlen közös hibapontunk.
A helyreállító rendszernek pedig különösen fontos, hogy ne függjön attól, amit helyre kell állítania.
Számomra az egész történetben nem az a meglepő, hogy egy mérnök hibás konfigurációt készít. Ilyesmi bárhol előfordulhat.
Hanem az, hogy a világ legnagyobb technológiai vállalatai olyan komplex infrastruktúrákat építenek, amelyekben egyetlen konfigurációs hiba következményei globális méretűvé válhatnak.
És az igazán érdekes kérdés nem az, hogy hány redundáns szerverük van.
Hanem az, hogy hány valóban független hibadoménjük.